


Предиктивная аналитика в клинике: прогнозируем поток пациентов
Что такое предиктивная аналитика и зачем она клинике
Предиктивная аналитика в клинике это не гадание на кофейной гуще, а математическая модель, которая предсказывает будущий спрос на медицинские услуги. Она анализирует исторические данные, сезонность, эпидемиологическую обстановку и даже погоду, чтобы ответить на вопрос: сколько пациентов придет завтра, через месяц или в пик сезона. Для клиники это означает возможность заранее скорректировать график врачей, закупить расходные материалы и избежать простоя персонала, а не реагировать на уже случившийся хаос в регистратуре.
Ключевое отличие от классической ретроспективной аналитики в том, что последняя отвечает на вопрос «что произошло?», а предиктивная работает с «что произойдет?». Обычный отчет покажет, что в октябре был всплеск обращений к ЛОРу, но не подскажет, что в этом году из-за раннего похолодания его стоит ожидать уже в сентябре. По сути, это переход от констатации фактов к управлению загрузкой: вы не просто фиксируете загруженность врачей, а прогнозируете ее с точностью до дней, что напрямую влияет на запись и финансовое планирование. Именно поэтому такой подход становится обязательным элементом продвижения сайта клиники, ведь он неразрывно связан с конверсией и удобством онлайн-записи.
Какие данные нужны для прогнозирования потока пациентов
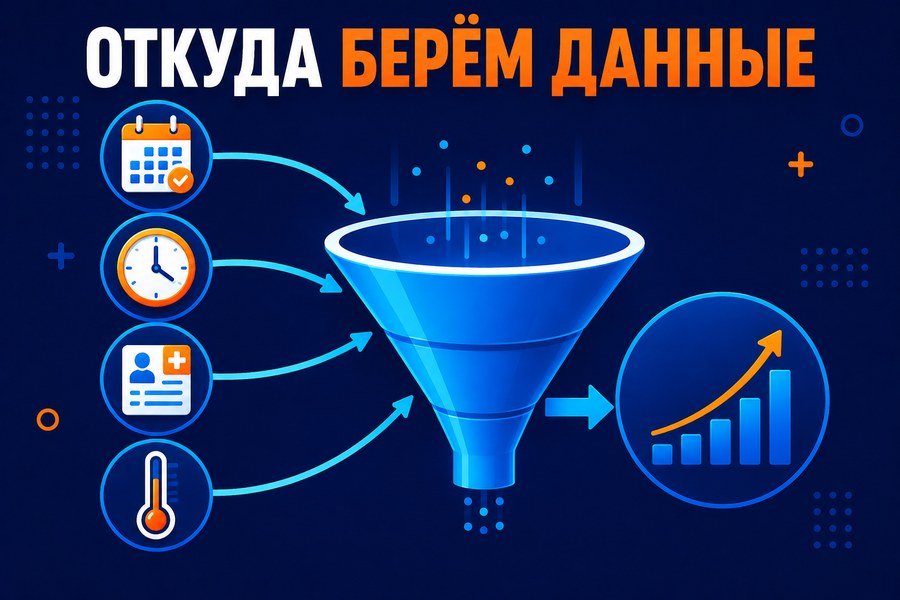
Начинать прогноз потока пациентов стоит с внутренних данных, и здесь клиникам обычно есть чем похвастаться. Базой служат исторические записи из медицинской информационной системы: количество обращений по дням и часам, структура посещений по специальностям, доля первичных и повторных приёмов. Отдельно собираем данные о записи через сайт и колл-центр, чтобы понять, какой канал приносит стабильный спрос, а какой проседает в определённые периоды. Эти массивы за 2–3 года уже позволяют увидеть устойчивые недельные и месячные циклы, а статья о прогнозировании сезонности спроса хорошо показывает, почему без учёта таких колебаний модель будет давать сбой.
Второй блок данных это внешние факторы, которые напрямую бьют по загрузке регистратуры. Эпидемиологическая обстановка в регионе, данные Роспотребнадзора о заболеваемости ОРВИ, сезонные аллергии и даже погодные аномалии заметно сдвигают спрос на приём терапевта или ЛОРа. В реальности мы часто комбинируем эти сигналы с маркетинговой статистикой: расходами на контекстную рекламу, числом лидов из соцсетей и активностью email-рассылок. Предиктивная модель в клинике работает точнее, когда учитывает не только прошлые записи, но и то, что происходит за окном прямо сейчас.
Помимо перечисленного, в модель стоит загрузить данные о простоях врачей и отменах записей, очищенные от технических сбоев: они показывают реальную пропускную способность отделений, а не идеальную картину из расписания. Расходы на рекламные каналы и конверсия в визит по каждому направлению тоже пригодятся, иначе нельзя отделить органический спрос от платного. Не забываем про статистику заболеваемости по региону из открытых источников и сводок эпидемиологов, а также календарь праздников, школьных каникул и сезонных акций клиники. Эти факторы по отдельности выглядят второстепенными, но вместе они объясняют до трети отклонений фактической загрузки от средних значений.
- Выгрузка из МИС за последние 24 месяца по всем специальностям и типам приёмов.
- Логи записи через сайт, мобильное приложение и колл-центр с метками источника.
- Данные о простоях врачей и отменах записей, очищенные от технических сбоев.
- Расходы на рекламные каналы и конверсия в визит по каждому направлению.
Методы и модели: от регрессии до машинного обучения
Начать стоит с классики: линейная регрессия и ARIMA до сих пор работают там, где данных мало и они стабильны. Линейная регрессия хороша для базовой оценки влияния факторов вроде дня недели или сезонности, но на реальных потоках пациентов она часто ошибается из-за нелинейных зависимостей. ARIMA справляется с временными рядами лучше, особенно если у вас есть 2–3 года помесячной статистики, но модель ломается, когда в данные вмешиваются разовые события: эпидемии, новые тарифы или открытие филиала.
Методы машинного обучения дают заметно более высокую точность, но требуют большего объёма истории и аккуратной предобработки. Случайный лес устойчив к выбросам и хорошо работает даже на таблицах с 10–15 признаками, градиентный бустинг (XGBoost, CatBoost) выигрывает, когда признаков много и есть сложные взаимодействия, а нейросети оправданы только при очень больших объёмах данных, обычно от 50 тысяч записей. На практике мы в Cinar чаще используем бустинг: он даёт точность 85–90% при умеренных затратах на внедрение. Для прогнозирования потока пациентов полезно также анализировать текущий анализ трафика сайта, чтобы выявить закономерности и тренды, которые не видны в регистратуре.
| Метод | Точность | Сложность внедрения | Требования к данным |
|---|---|---|---|
| Линейная регрессия | Низкая, 50–65% | Низкая | От 3–6 месяцев истории |
| ARIMA | Средняя, 65–75% | Средняя | 2+ года, равномерные ряды |
| Случайный лес | Высокая, 75–85% | Средняя | 1+ год, 10+ признаков |
| Градиентный бустинг | Очень высокая, 85–90% | Высокая | 1–2 года, 15+ признаков |
| Нейронные сети | Максимальная, при достаточных данных | Очень высокая | От 50 тыс. записей, GPU |
Инструменты для предиктивной аналитики в медицине
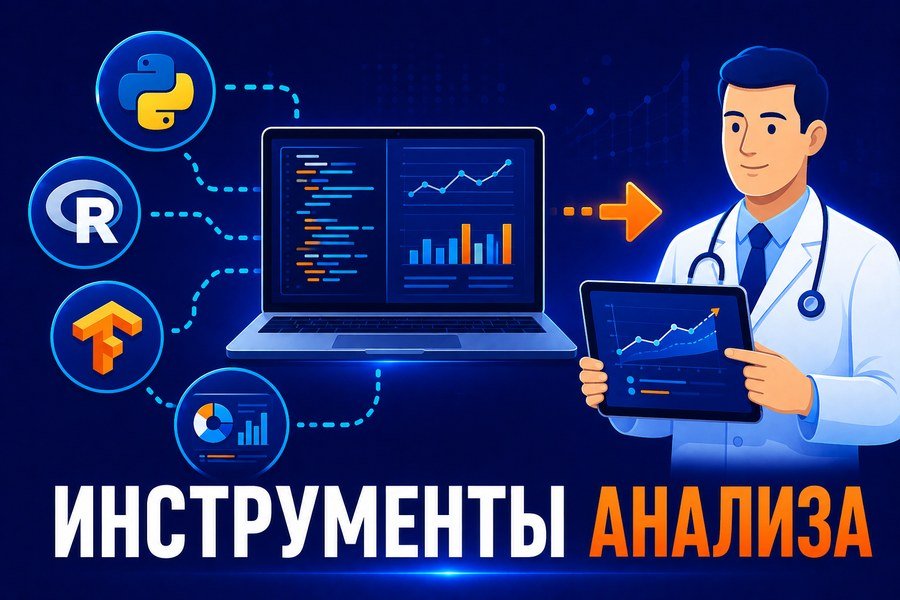
Начинать стоит с того, что уже есть под рукой. Excel или Google Sheets с подключёнными данными из МИС закрывают базовые задачи: сезонные коэффициенты, скользящее среднее, простую линейную регрессию. Для небольшой клиники на 5–10 врачей этого часто хватает, чтобы спрогнозировать загрузку на месяц вперёд. Когда данных становится больше, а отчётность нужна руководителю каждый понедельник, подключают BI-системы вроде Power BI или Tableau. Они визуализируют тренды и позволяют «покрутить» сценарии без программирования. Предиктивная аналитика в клинике на этом уровне работает через встроенные модели, но точность падает, если поток пациентов сильно зависит от внешних факторов, например, от рекламных кампаний.
Для сети клиник или крупного центра одного Excel уже мало. Здесь нужны Python или R: библиотеки statsmodels, scikit-learn, Prophet от Meta. На них строят модели с учётом десятков признаков: погода, день недели, запись через сайт, отмены, сезонность. На практике мы обычно гибридим: BI-система остаётся витриной для руководства, а расчёты крутятся в Python-скриптах, которые раз в сутки подтягивают данные из МИС и выгружают прогноз обратно в Power BI. Порог входа выше, но и результат серьёзнее, например, можно предсказать нехватку слотов у конкретного специалиста за две недели.
Как мы в Cinar прогнозируем поток пациентов: пошаговый алгоритм
Начинаем с аудита данных, и здесь чаще всего всплывает главная проблема: записи в медицинской системе хаотичны, часть полей пустует, а история посещений размазана по бумажным картам. Мы обычно выгружаем данные за два-три года, чистим дубли и приводим к единому формату, иначе модель будет учиться на мусоре. Следом выбираем модель: для прогноза потока на месяц вперёд часто хватает градиентного бустинга или сезонной декомпозиции временного ряда, а для почасовой загрузки кабинетов уже нужны более сложные рекуррентные сети. На практике мы не гонимся за сложностью, сначала проверяем простую линейную регрессию, чтобы понять, тянет ли база хотя бы на базовый прогноз.
Дальше идёт валидация, и это самый недооценённый этап. Модель может показывать отличную точность на обучающей выборке и проваливаться на реальных данных, поэтому мы режем историю на обучающий и тестовый периоды, например, 24 месяца против последних трёх, и смотрим на ошибку MAPE. Если расхождение по дням недели превышает 10–15%, калибруем модель, добавляя внешние факторы вроде сезонности гриппа или графиков работы врачей. Только после этого подключаем прогноз к процессам: выводим ожидаемую загрузку в дашборд администратора и автоматически корректируем расписание, чтобы пиковые часы не создавали очередей.
Типичные ошибки при внедрении предиктивной аналитики
Чаще всего проблемы начинаются ещё до построения модели, на этапе сбора данных. В клиниках нередко пытаются прогнозировать поток пациентов по записям из админки, где половина полей заполнена «от балды», а часть визитов вообще не отражена. Если в данных есть пропуски, дубли и ошибки в датах, любая, даже самая умная модель выдаст мусор. Мы обычно тратим до 60% времени на чистку и нормализацию данных, и это не перестраховка: без этого прогноз по записи на завтра будет отличаться от реальности на 30–40%. Второй типичный промах, переобучение, случается, когда модель слишком хорошо запоминает исторические данные и перестаёт обобщать. Она отлично предсказывает прошлый месяц, но на новых данных начинает ошибаться, потому что улавливает шум, а не закономерности.
Сложность моделей тоже играет злую шутку. В погоне за точностью команды собирают нейросети там, где достаточно линейной регрессии, а потом не могут объяснить, почему модель дала такой результат. Интерпретируемость в медицине критична: если заведующий отделением не понимает, почему прогноз такой, он просто не будет ему доверять. Не менее важно не игнорировать внешние факторы, сезонность гриппа, праздники, отъезды населения. И, наконец, главная ошибка, неверная интерпретация: прогноз даёт вероятность, а не гарантию, и если закладывать его как жёсткий план, а не как ориентир, разочарования не избежать. Чтобы этого не случилось, всегда валидируйте модель на отложенной выборке и сравнивайте прогноз с фактом хотя бы раз в месяц, это быстрее всего покажет, где модель «поплыла».
Кейсы: как прогнозирование помогло клиникам
В стоматологической сети из трёх клиник мы спрогнозировали поток на основе данных записи за два года и сезонности. Модель показала, что пик обращений приходится на утренние часы вторника и четверга, а после обеда пятницы загрузка падает на 40%. Клиника сдвинула приём гигиенистов на вечерние часы, а сложные хирургические случаи запланировала на утро среды. Загрузка кресел выросла с 61% до 78% за три месяца, а время ожидания пациента сократилось с 25 до 12 минут.
В многопрофильном центре с восемью отделениями прогноз на основе данных из МИС и записей на лабораторные исследования помог иначе расставить приоритеты. Модель выявила, что 30% пациентов, приходящих на УЗИ, тут же записываются к терапевту. Центр увеличил слоты терапевта в дни максимального потока УЗИ и сократил их в понедельник, когда поток минимален. Это позволило снизить простои кабинетов на 22% и увеличить средний чек за счёт дополнительных приёмов. Практика показывает, что предиктивная аналитика в клинике работает быстрее всего, когда данные собираются из одной системы, а не из пяти разных таблиц.
- Прогноз за 2 недели позволил стоматологии сократить простои кресел на 17% без найма дополнительного персонала.
- Модель по сезонным всплескам ОРВИ помогла многопрофильному центру заранее увеличить слоты педиатра на 15% в ноябре.
- Анализ отмен и неявок дал клинике точность прогноза явки 89%, что снизило потери времени врачей.
- Прогнозирование потока в диагностическом отделении сократило очередь на МРТ с 5 дней до 2,5 дней.
- Данные по повторным визитам позволили клинике увеличить загрузку физиотерапии на 20% за счёт переноса слотов на вечернее время.
С чего начать: чек-лист для внедрения предиктивной аналитики
Начните с малого: выберите одну услугу или отделение с наибольшим потоком записей и соберите данные за 12–24 месяца. Это может быть расписание врачей, число первичных и повторных приемов, отмены, сезонность. Уже на этом этапе подключите Яндекс.Вебмастер и Google Search Console, чтобы отслеживать поисковые запросы, которые приводят пациентов, это даст первичную картину спроса без сложных моделей. Дальше определите, какие внешние факторы влияют на поток: эпидсезон, погода, рекламные кампании, и решите, хватит ли простой регрессии или нужны алгоритмы машинного обучения.
Практический чек-лист выглядит так: сформировать команду из администратора, аналитика и врача, выбрать инструмент (от Excel и Python до готовых BI-платформ), выгрузить данные в единую таблицу, очистить их от дублей и пропусков, построить базовую модель прогноза на 4–8 недель, сверить прогноз с фактом и скорректировать параметры. После этого можно переходить к автоматизации отчетов и интеграции с системой записи. Предиктивная аналитика в клинике окупается быстрее, если начать с одной гипотезы, например, перераспределения нагрузки на врачей, и только потом масштабировать. Мы в Cinar помогаем клиникам проходить этот путь от сбора данных до работающего прогноза, адаптируя методику под конкретные задачи и ресурсы.
Часто задаваемые вопросы
Наш блог c полезными советами
 28.09.2026
Как продать клинику: оценка бизнеса и подготовка к сделке
 28.09.2026
Предиктивная аналитика в клинике: прогнозируем поток пациентов
 28.09.2026
План продаж клиники: как ставить и выполнять
 28.09.2026
Отзовики для клиники: стратегия работы с Отзовиком, IRecommend и Яндексом
 28.09.2026
Открытие медицинского кабинета частной практики: с чего начать
 28.09.2026
Открытие массажного кабинета: пошаговая инструкция